不同达人平台给同一个人的可信度分数都不一样,品牌该信哪个?
达人平台评分冲突时,先核对定义和时间范围,再用近期内容、评论、受众地域与增长变化完成一套可复核的人工审计。

同一个达人,在一个工具里评分很高,在另一个工具里却被提示有风险。把两个数字平均一下,并不能告诉团队该不该联系。先确认两个分数各自评估什么、覆盖哪段时间,再核对同一批近期内容与受众证据。分数可以帮助安排复核顺序,合作决定应有可回看的依据。
在一则讨论达人平台用途的公开评论中,有参与者提醒:不同工具的评分方法会有差异,单一分数应作为一个线索,并建议查看达人近期帖子的评论。这里讨论的是如何复核线索,不是给某个账号作真实性定论。
为什么同一个达人会拿到不同分数?
“可信度”不是一个跨平台统一的官方指标。不同工具可能使用不同数据源、观察时间、异常规则和权重。有的更看粉丝增长,有的更看互动分布,有的把受众地域或账号质量纳入模型。即使名称相近,分数也未必在回答同一个问题。
| 先问什么 | 为什么重要 | 记录方式 |
|---|---|---|
| 分数定义是什么 | 避免把“互动质量”误读成“受众匹配” | 保存帮助页、版本和查看日期 |
| 覆盖哪段时间 | 爆款、停更或短期活动会改变样本 | 写清起止时间 |
| 数据来自公开信息还是授权数据 | 可见范围决定结论边界 | 标注来源口径 |
| 异常阈值能否解释 | 黑箱分数不能直接指导复核 | 列出待人工检查项 |
先把三家工具的结果放在同一张表中,分数旁边保留定义、日期和数据范围。OneCrew 是连接达人发现、邮件沟通与合作记录的 AI 工作台;你可以把候选主页、相关内容、工具结果和人工备注放进同一条达人记录,让团队看到“为什么入围”,而不只是一个总分。
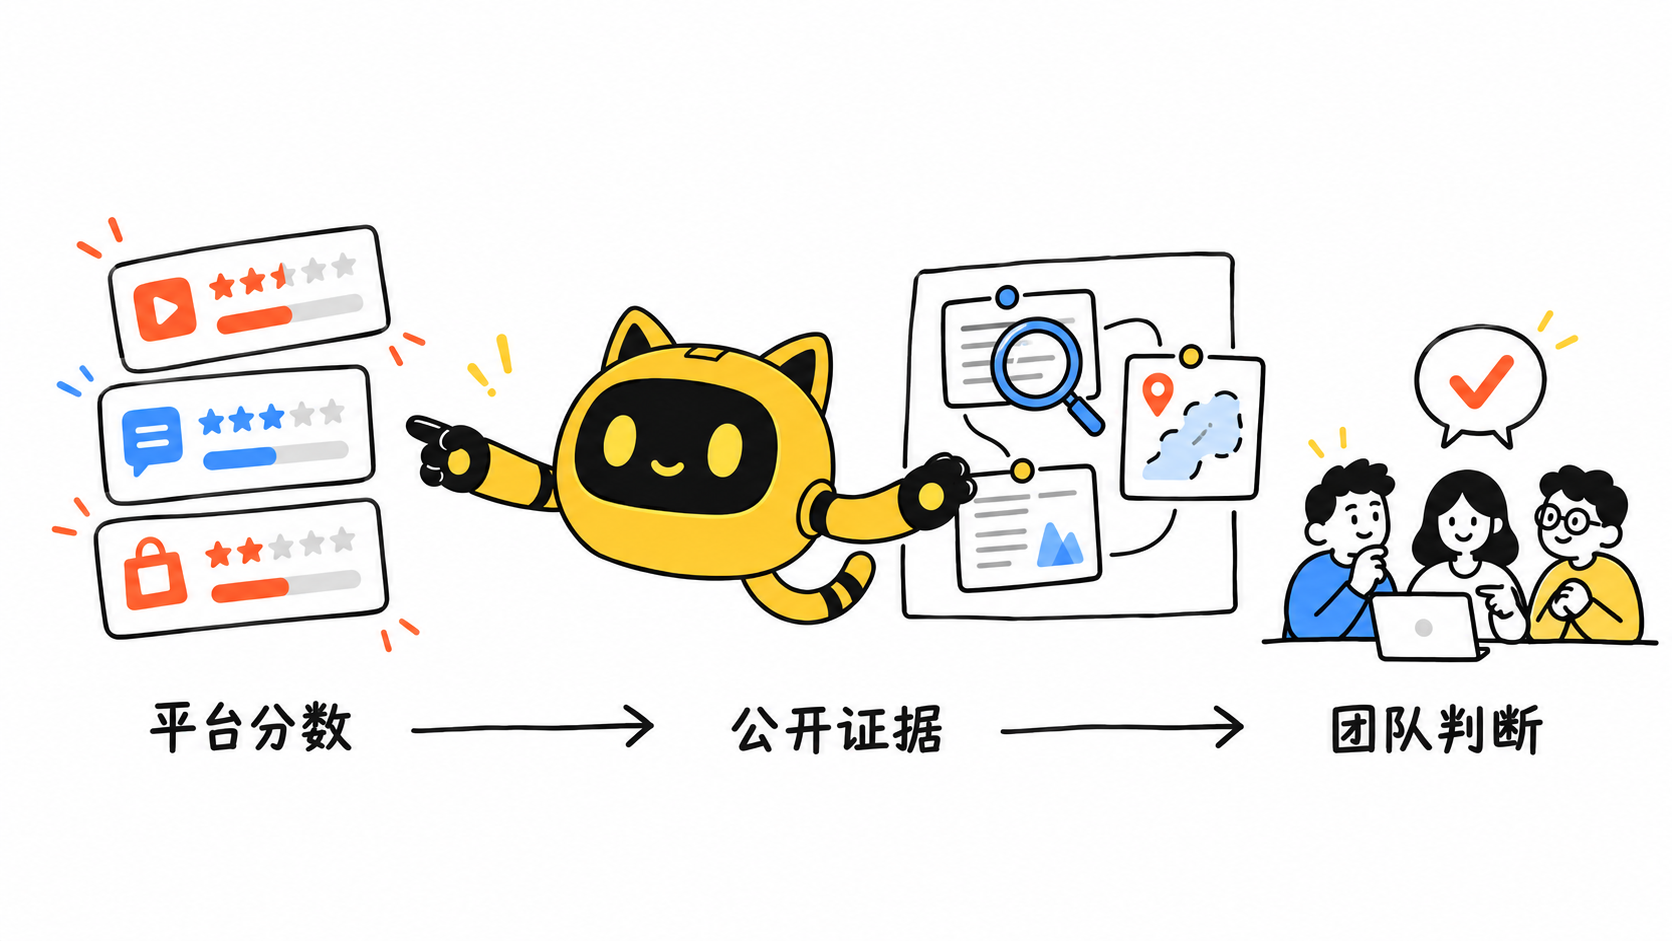
用五步人工抽样,把分数还原成可复核判断
第一步:先写本轮需要什么受众
至少写清市场、语言、内容主题、使用场景和本轮交付。一个受众真实但不在销售市场的达人,仍然可能不适合;一个总体互动普通、却持续回答细分产品问题的达人,反而可能更匹配。
第二步:抽查近期相关内容,不只看账号总览
从最近一段可代表当前状态的内容中,选 3–5 条与产品场景相近的帖子。记录发布日期、播放或互动的公开口径、是否为广告、内容是否偏离日常主题。不要只挑最高表现的一条,也不要把不同平台的播放定义混在一起。
第三步:读评论在讨论什么
把评论粗分为泛赞美、真实使用问题、比较问题、购买问题和无关互动。重复短句、与内容无关的表情或突然出现的异常语言分布可以触发复核,但单个信号不能直接证明虚假。保存少量代表性评论和原始链接,方便同事复看。
第四步:核对地域和增长变化
达人所在地、粉丝所在地和具体内容的观看地域是三件事。需要非公开数据时,只向入围者索取影响决定的那一项,并写清统计对象和时间范围。增长曲线出现突变时,先检查是否有爆款、平台推荐、抽奖或媒体曝光等解释,再决定是否继续。
把抽查内容的链接、原始评论和团队判断分栏记入 OneCrew 工作表,让接入的 AI 整理哪些判断有来源、哪些信息尚缺。若地域数据会影响选择,就依据这份缺项清单准备询问草稿;核对统计对象、时间范围和收件人后再发送。
第五步:把结论写成证据句
不要只写“可信”或“不可信”。例如,以下是一条虚构示例,实际使用时替换成已核实的事实:“近 5 条同类内容中,3 条出现具体使用问题;受众地域截图覆盖最近 30 天;平台 A 的异常提示尚无法解释,因此先做小额测试。”在 OneCrew 中把这句话、证据链接、负责人和下一步保存在候选记录里,后续外联与复盘就能沿用同一依据。
一个可直接使用的达人可信度人工核对表
| 维度 | 检查动作 | 通过不是指什么 |
|---|---|---|
| 内容匹配 | 抽查 3–5 条相关内容 | 不是偶尔提过同类产品 |
| 评论质量 | 分类真实问题与泛互动 | 不是评论越多越好 |
| 受众地域 | 确认指标、时间和范围 | 不是达人住在哪就代表粉丝在哪 |
| 增长变化 | 查找突变与可解释事件 | 不是增长快就一定异常 |
| 商业透明 | 看合作披露与历史内容 | 不是广告多就一定不适合 |
| 团队结论 | 写证据句和下一步 | 不是复制平台总分 |
常见问题
应该相信分数最高的平台吗?
不应该只凭最高分决定。先比较定义、时间范围和数据来源,再用同一人工样本复核。
评论异常就代表买粉吗?
不能这样下结论。评论异常是复核信号,还需要结合内容、时间、地域和增长事件判断。
没有达人后台截图还能筛选吗?
可以先用公开内容做初筛,把缺少的受众数据标为待确认;只向入围者索取下一步必需的数据。
若还需要区分互动热闹与购买意图,可接着查看怎样筛选更可能转化的达人;这是评分复核之后的另一个判断。
从一个候选人开始复核
先选一位不同工具评分冲突最大的候选人,完成“分数定义—公开内容—评论样本—地域口径—证据句”五项检查。把来源和结论保存到 OneCrew,再由团队决定淘汰、小额测试或继续沟通。这样分数仍然有用,但不会替代你的判断。